Hình ảnh này. Một nhóm tài chính đã lưu trữ các báo cáo và hồ sơ giao dịch của khách hàng như PDF/A trong sáu năm qua. Mọi tệp đều mang thẻ siêu dữ liệu phù hợp. Mọi nhân viên đều tin rằng công việc đã hoàn thành ngay khi tệp được lưu. Sau đó, cơ quan quản lý xuất hiện để đánh giá định kỳ, chạy một số tệp đó thông qua trình xác thực và một nửa trong số đó không thành công.
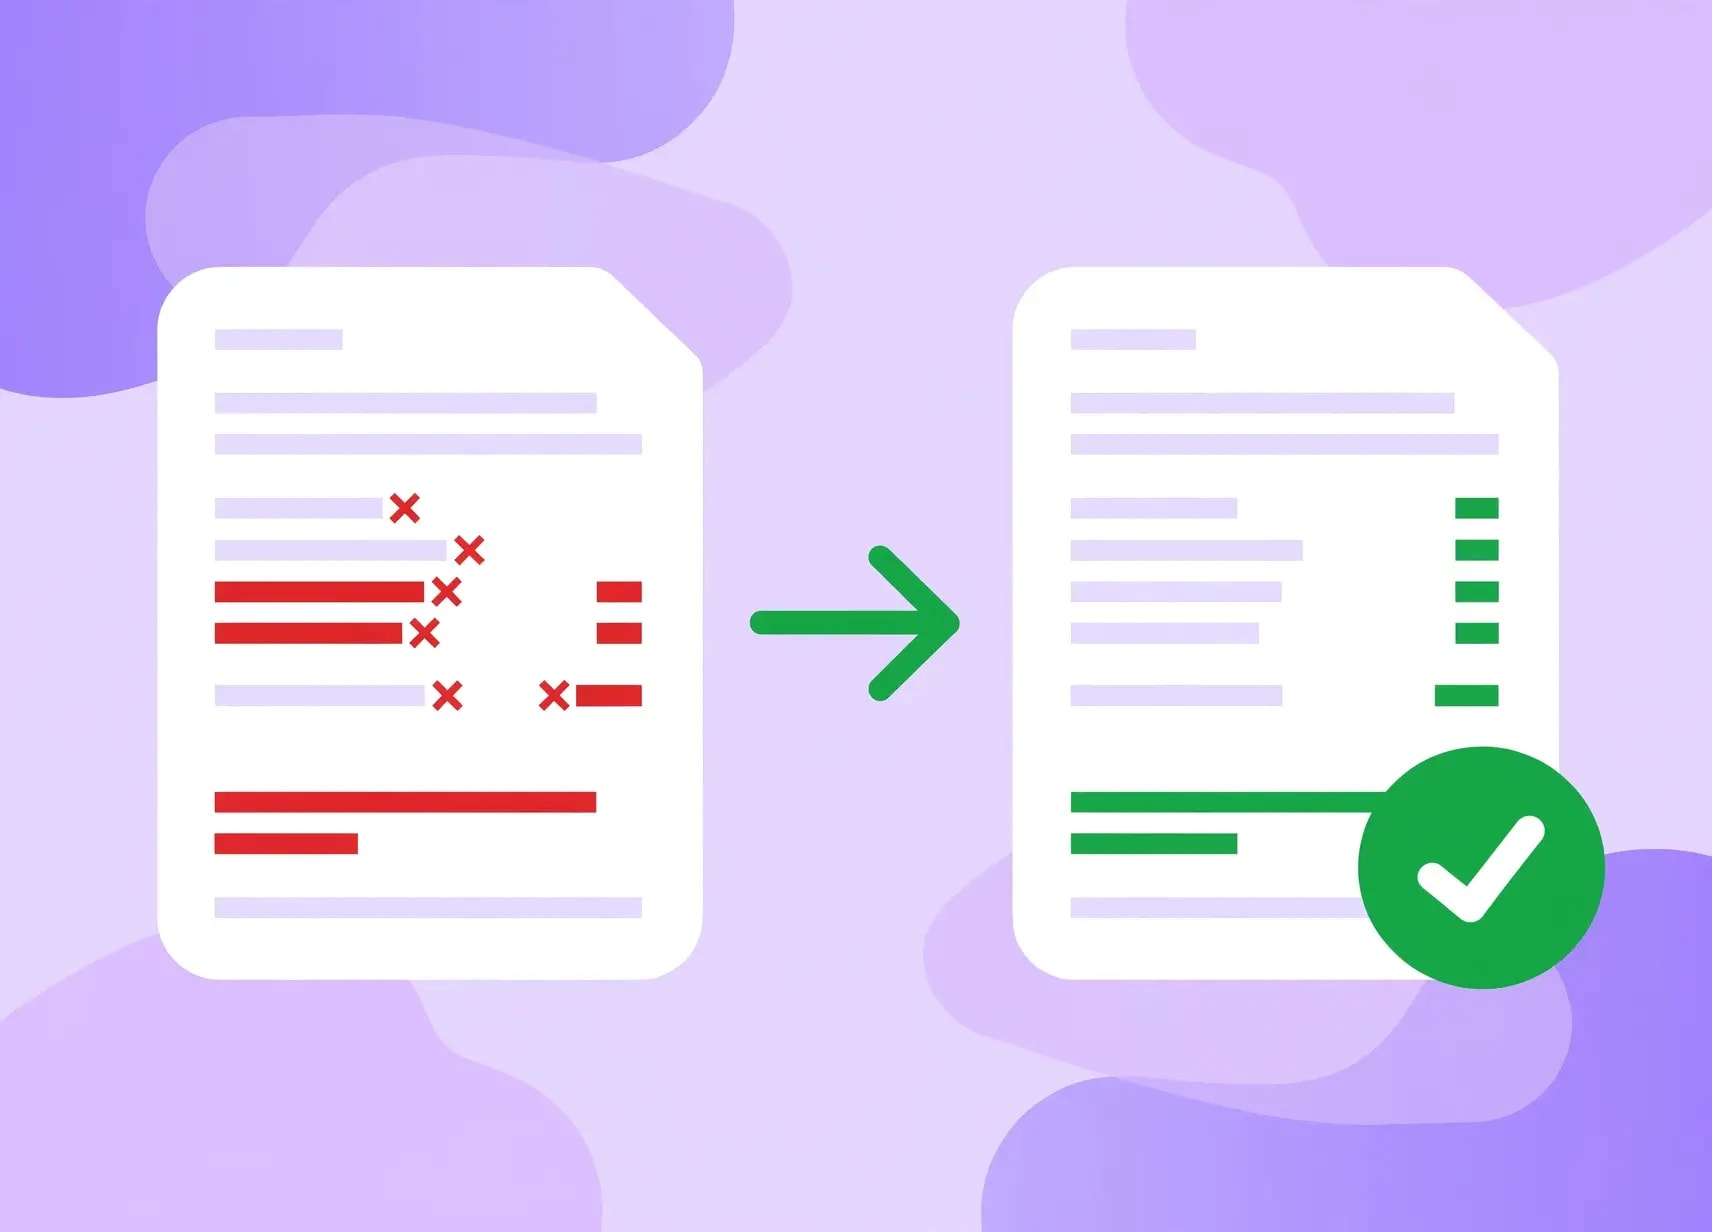
Không có tài liệu nào được chạm vào, không có gì được thực hiện khác đi. Những tài liệu này ngay từ đầu chưa bao giờ tuân thủ, họ chỉ tuyên bố tuân thủ. Và chính sự khác biệt giữa “tự nhận là PDF/A” và “là PDF/A” là một trong những điểm mù thường xuyên và tốn kém nhất trong việc lưu trữ tài liệu hiện nay.
Vì vậy, nếu nỗ lực lưu trữ của bạn không thành công và/hoặc nếu bạn muốn tiếp tục làm đúng quy trình thì đây là điều thực sự sai và cách thiết lập quy trình làm việc mạnh mẽ cho Tuân thủ PDF/A.
Tại sao việc tuân thủ PDF/A lại quan trọng hơn hầu hết các nhóm nhận ra
PDF/A không chỉ là "PDF có tính năng lưu trữ". Đó là định dạng được xác định theo tiêu chuẩn ISO nhằm đảm bảo rằng tài liệu sẽ mở và trông giống hệt như bây giờ, trong mười năm và trong năm mươi năm nữa, bất kể phần mềm hoặc phông chữ nào đã được cài đặt để đọc nó vào thời điểm đó.
Điều đó có rất nhiều ý nghĩa khi liên quan đến quy định. Các quy định như GDPR yêu cầu công ty phải duy trì tính toàn vẹn, bảo mật và tính sẵn có của dữ liệu cá nhân của mình. Các quy định như MiFID II yêu cầu một công ty lưu trữ dữ liệu giao dịch và liên lạc từ khách hàng trong nhiều năm ở định dạng không thể thay đổi một cách bí mật. Làm điều gì đó sai ở đây và bạn có thể phải đối mặt với các khoản tiền phạt được tính bằng tỷ lệ phần trăm một chữ số trong doanh thu hàng năm của bạn, đây là một số tiền đáng kể đối với một công ty lớn.
Đó là lý do tại sao khi Tuân thủ PDF/A thiếu kho lưu trữ, nó không được coi là vấn đề với công nghệ. Đây được coi là một vấn đề tuân thủ quy định và trách nhiệm thuộc về công ty được đề cập.
Những lý do phổ biến nhất khiến tệp PDF/A không được xác thực
Hầu hết các lỗi PDF/A đều bắt nguồn từ một danh sách ngắn các sự cố định kỳ. Đây là nơi mọi thứ thường đi sai.
Phông chữ chưa được nhúng hoàn toàn
Không còn nghi ngờ gì nữa, đây là nguyên nhân phổ biến nhất của vấn đề. Đối với tệp PDF/A, tất cả các phông chữ được sử dụng trong tài liệu phải được nhúng vào tệp để người xem không phải cài đặt phông chữ trên máy của mình. Trong nhiều trường hợp, chỉ có tập hợp con của phông chữ được nhúng vào tệp PDF, điều này thường không thực hiện được quá trình xác thực. Từ các nghiên cứu trước đây được thực hiện trên các tệp PDF/A ngoài đời thực, người ta nhận thấy rằng hơn một nửa số trường hợp không tuân thủ phát sinh từ phông chữ.
Không gian màu độc lập với thiết bị
Theo yêu cầu của PDF/A, màu sắc phải được mô tả thông qua cấu hình ICC độc lập với thiết bị để đảm bảo hiển thị nhất quán bất kể bạn sử dụng màn hình hiển thị, máy in hay phần mềm ứng dụng nào để xem tài liệu. Điều thú vị là, một trong những lỗi thường gặp nhất khi tạo PDF/A liên quan đến tài liệu dựa trên một số không gian màu (chẳng hạn như sRGB đơn giản) thiếu cấu hình ICC cần thiết.
Siêu dữ liệu không khớp với thực tế
Mỗi tài liệu PDF/A phải chứa siêu dữ liệu XMP cho biết nó tuân thủ phiên bản PDF/A nào (PDF/A-1, -2 hoặc -3) và ở mức độ tuân thủ nào (A, B hoặc U). Việc không cung cấp siêu dữ liệu đó hoặc cung cấp siêu dữ liệu đó theo cách sai sót hoặc gây nhầm lẫn có nghĩa là thất bại ngay lập tức trước khi quá trình kiểm tra bắt đầu.
Lịch sử cập nhật gia tăng lộn xộn
Bản cập nhật gia tăng sẽ thêm dữ liệu bổ sung vào tài liệu PDF hiện có mà không cần viết lại toàn bộ tài liệu từ đầu. Đây là một lựa chọn thuận tiện trong các tập tin PDF tiêu chuẩn, nhưng đối với Tệp PDF/A, nó được thực hiện một cách thận trọng:
- •PDF/A-1 hoàn toàn không cho phép cập nhật gia tăng. Bất kỳ chỉnh sửa nào cũng phải tạo ra một bản viết lại đầy đủ của tập tin.
- •Trong PDF/A-2 và PDF/A-3, được phép cập nhật gia tăng; tuy nhiên, dữ liệu được thêm vào phải phù hợp với phần còn lại của tài liệu. Ví dụ: việc thêm một bản sửa đổi bằng cách sử dụng phông chữ không được nhúng sẽ khiến toàn bộ tệp không hợp lệ.
- •Số phiên bản trong tiêu đề của tệp cũng cần khớp với phiên bản được khai báo bên trong danh mục nội bộ của tài liệu. Sự không phù hợp ở đây là điều dễ bị bỏ sót và là cách dễ dàng để xác thực không thành công.
Việc chuyển đổi tài liệu sang PDF/A không tương đương với việc xác thực PDF/A
Đó là lĩnh vực mà nhiều công ty vấp ngã; và nó phải được nêu rõ ràng.
Chuyển đổi lấy một tài liệu, bất kể định dạng ban đầu của nó (có thể là tài liệu Word, trang HTML hoặc PDF) và chuyển đổi nó thành một định dạng Tệp PDF/A. Khi làm như vậy, phần mềm sẽ thêm siêu dữ liệu chứng nhận tệp mới được tạo là tệp tuân thủ PDF/A.
Xác thực là một quy trình hoàn toàn khác, trong đó chương trình đặc biệt xác minh rằng tệp thực sự đáp ứng tất cả các yêu cầu để được chứng nhận.
Nhưng điểm mấu chốt ở đây là: Siêu dữ liệu được chèn ở giai đoạn chuyển đổi là một tuyên bố chứ không phải là bằng chứng. Tệp có thể chứa thông tin trong siêu dữ liệu rằng nó tuân thủ PDF/A-2b nhưng không vượt qua được quá trình xác minh PDF/A-2b.
Làm cho điều này trở nên tồi tệ hơn, nhiều nguồn mở và miễn phí Trình xác thực PDF/A sử dụng phương pháp phỏng đoán chứ không phải so sánh từng dòng với toàn bộ đặc điểm kỹ thuật. Điều này có nghĩa là họ thường cho rằng một tài liệu "có thể" hợp lệ, điều này thoạt nghe có vẻ là tin tốt nhưng chắc chắn không phải vậy. Một cách khác để xác minh sự tuân thủ là trực quan, trong đó ai đó chỉ cần mở tài liệu và xem liệu nó có đúng hay không.
Tối thiểu, mọi tệp PDF/A cần phải:
- •Nhúng trực tiếp tất cả phông chữ, hình ảnh và nội dung mà không có gì được tham chiếu bên ngoài
- •Tránh hoàn toàn các dạng âm thanh, video, JavaScript và XFA
- •Bỏ qua việc nén, mã hóa và bảo vệ bằng mật khẩu LZW
- •Cung cấp cho mỗi trường biểu mẫu tương tác một từ điển giao diện phù hợp
- •Lưu trữ siêu dữ liệu bằng tiêu chuẩn XMP
Bỏ qua xác thực và bạn tin tưởng rằng mọi hộp trong số này đều đã được kiểm tra chính xác mà không bao giờ thực sự xác nhận nó.
Mức độ phù hợp không thể thay thế cho nhau
Một nguồn kiểm tra thất bại lặng lẽ khác là mức độ tuân thủ không khớp, trong đó một tệp tuyên bố mức độ tuân thủ mà nó không thực sự đáp ứng.
Hai điều đáng hiểu ở đây:
Bản thân các tiêu chuẩn là khác nhau. PDF/A-1, PDF/A-2 và PDF/A-3 được xuất bản cách nhau nhiều năm và không có quy tắc giống hệt nhau. Ví dụ: PDF/A-1 không hỗ trợ độ trong suốt hoặc lớp và chỉ cung cấp mức tuân thủ A và B. PDF/A-2 đã bổ sung hỗ trợ cho độ trong suốt, lớp và thậm chí nhúng các tệp PDF/A khác, cùng với cấp độ mới, U.
Các mức độ phù hợp được xây dựng dựa trên nhau. Cấp U bao gồm mọi thứ cần thiết cho cấp B và cấp A bao gồm mọi thứ cần thiết cho cấp U và hơn thế nữa. Chọn cấp độ phù hợp không chỉ là một chi tiết kỹ thuật mà còn là một quyết định có hậu quả thực sự đối với khả năng sử dụng được kho lưu trữ của bạn trong nhiều năm tới. Ví dụ: kho lưu trữ khiếu nại trong đó tài liệu cần duy trì khả năng tìm kiếm và trích xuất văn bản cần ít nhất là cấp U. Chỉ cấp B sẽ không đảm bảo điều đó.
Cấp độ U đặc biệt là về tính toàn vẹn của văn bản. Nó đảm bảo văn bản Unicode cơ bản trong tài liệu có thể được trích xuất hoặc tìm kiếm một cách đáng tin cậy sau này, điều này rất quan trọng đối với bất kỳ kho lưu trữ nào có thể cần được xem xét hoặc tìm kiếm nhiều năm sau khi lưu trữ.
Đường dẫn PDF/A được kiểm toán thực sự trông như thế nào
Một quy trình lưu trữ có thể bảo vệ thường tuân theo hình thức này:
Chuẩn hóa tài liệu nguồn → Chuyển đổi sang PDF/A → Xác thực độc lập → Lưu trữ tệp
Đây là bước mà hầu hết các tổ chức thường bỏ qua nhưng lại là bước quan trọng nhất. Trong trường hợp phần mềm chuyển đổi file sang dạng khác là phần mềm xác thực quá trình chuyển đổi thì tất cả những gì bạn làm là xác thực đầu ra do phần mềm tạo ra dựa trên thông số kỹ thuật mà phần mềm hiểu được. Những diễn giải không chính xác về thông số kỹ thuật do phần mềm thực hiện sẽ không được phát hiện cho đến khi tệp được xác thực bởi người xác thực độc lập.
Một lộ trình kiểm tra vững chắc nên bao gồm:
- •Bản ghi về ai đã chuyển đổi từng tệp và khi nào
- •Tên và phiên bản của công cụ được sử dụng
- •Một báo cáo xác thực độc lập xác nhận mức độ tuân thủ được yêu cầu, được đánh dấu thời gian lý tưởng và được lưu trữ cùng với chính tài liệu đó
Việc tạo và xác nhận dự kiến sẽ được thực hiện bởi các hệ thống khác nhau; báo cáo xác nhận cần phải có thể đọc được bằng máy và được lưu giữ làm bằng chứng kiểm toán; và tính nhất quán giữa nội dung được xác nhận và nội dung thực tế cần phải có thật. Theo GDPR và MiFID II, trách nhiệm đảm bảo bằng chứng về tính toàn vẹn hoàn toàn thuộc về chủ sở hữu kho lưu trữ chứ không phải nhà cung cấp phần mềm.
Phần kết luận
Tệp PDF/A chưa được xác thực độc lập thực sự chỉ là một tệp hy vọng nó tuân thủ. Điều đó có thể ổn trong nhiều năm, cho đến khi cơ quan quản lý yêu cầu xem kho lưu trữ. Xây dựng Xác thực PDF/A đưa vào hệ thống như một bước riêng biệt, độc lập là điều biến một kho lưu trữ đầy hy vọng thành một kho lưu trữ có thể bảo vệ được và xây dựng ngay bây giờ là một thói quen rẻ hơn nhiều so với việc phải trả tiền phạt sau này.
Thực hiện bước tiếp theo hướng tới tuân thủ PDF/A
Chuyển đổi sang PDF/AAn toàn trong tay chúng tôi
AziPDF rất coi trọng quyền riêng tư của bạn. Hãy nhớ rằng...